水稻基因家族分析-基因家族的鉴定
整个基因家族分析最耗费时间的一部分,也是最有用的一部分。
我本人是做水稻的,就以水稻为例,别的我也没做过。可能会有些不一样。
基因组文件获取
大概需要下面几个文件,其实CDS也是为了产生蛋白组文件用的。
- 基因组(genome)文件
- 编码区序列(CDS)文件
- 蛋白组文件
- 基因组注释文件
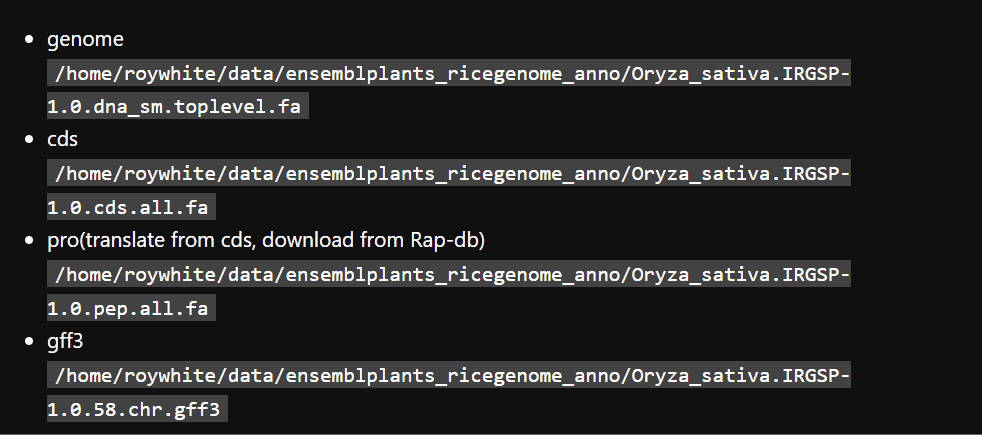
植物可以闭眼去ensembl plants上下载,这个网站比较全面。
当然你研究的物种有对应的基因组注释的网站配套不错的文章 最好。
水稻有个IRGSP-v1.0参考基因组,是非常常用的。
CDS有现成的,蛋白组也是基于CDS翻译的,有现成的。
如果没有CDS,应该可以测几个转录组,去基因组上mapping一下,就有了
如果只有CDS,自己翻译一下就行了
基因组文件中通常同一个基因会有多种长度不同的转录本,在进行基因家族分析时,默认使用最长的转录本作为一个基因的代表序列,一个基因对应一个转录本。
【这里TBTools可以直接完成。】
这里应该是最长转录本信息最多,也最大可能是对的。是一般情况下合理的用法。
这时候手上有个新的文件:
- 最长转录本代表蛋白质文件
搜库
按图索骥,首先要有一堆马,然后要一张图。
去参考文献看看目标基因是不是有保守结构域,有直接上PFAM上拿这个号,就直接能下载到hmm模型。没有就去直接拿这个基因序列去搜,找其它物种中已经报道的同源序列,做多序列比对,构建一个hmm模型。
然后直接hmmsearch
1 | hmmsearch \ |
建个blast库,把收集的多序列直接拿去blast。
当然也可以hmm模型用hmmemit生成一个序列再去blast。
1 | makeblastdb -in ./data/Oryza_sativa.IRGSP-1.0.pep.all.simp.rep.fa -out ./data/Oryza_sativa.IRGSP-1.0.pep.all.simp.rep -dbtype prot |
然后blast。
把hmm结果和blastp结果处理一下,提出id
放到一起去,去重。
然后拿合并去重的id去提取对应的pro序列。
检查
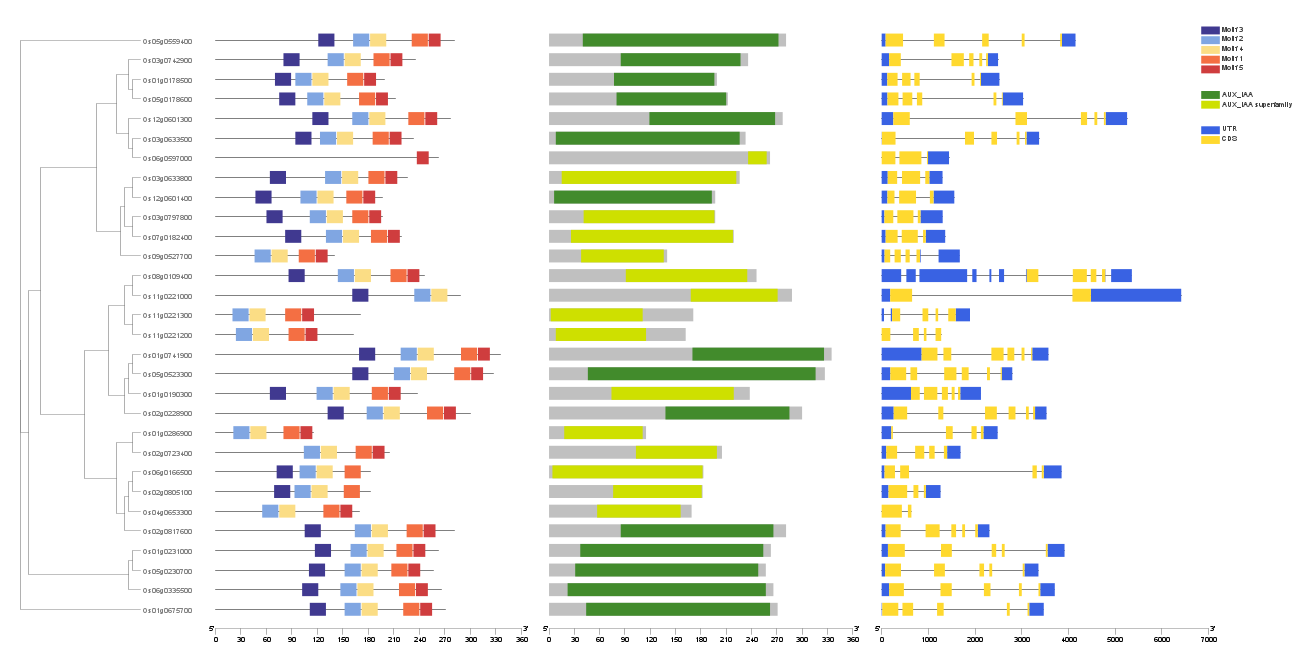
搜出来的序列建棵树,做个MUSCLEv5.0多重比对,丢进Batch-CDD里看看是不是都有结构域,丢进SMART里也看看,丢进MEME里也看看。
缺结构域的,长度不对的,串联重复的,都提出来重新检查,看看注释对不对,有没有转录本信息,做个实验瞅瞅表达不表达。
最后得到可信的,保存id,再提序列。
可视化
tbtools三件套
MEME
CD-Batch
TREE
组一个图出来。这样这部分就结束了。